Model AI seperti Llama, Qwen, dan DeepSeek berjalan privat di Cloud VPS: data tidak keluar, tanpa biaya per token.
Hosting Ollama adalah server untuk menjalankan model bahasa (LLM) secara lokal dengan Ollama. Di Cloud VPS DewaHoster, model kecil hingga menengah berjalan di CPU dengan data tetap privat dan tanpa biaya per token. Disarankan mulai 8 GB RAM untuk model 7–8B terkuantisasi.
 Rekomendasi: Cloud VPS
Ollama memudahkan mengunduh dan menjalankan model open source seperti Llama, Qwen, Gemma, dan DeepSeek. Cloud VPS kami berbasis CPU (tanpa GPU), sehingga paling cocok untuk model kecil hingga menengah: merangkum dokumen, klasifikasi, ekstraksi data, dan chatbot internal yang tidak butuh respons instan.
Semua yang dibutuhkan agar Ollama / LLM Lokal online cepat, aman, dan tenang.
Prompt dan dokumen diproses di server Anda, tidak dikirim ke API pihak ketiga.
Bayar server bulanan, pakai model sebanyak yang Anda butuhkan.
Instal paket, atur service, dan konfigurasi server sesuai kebutuhan aplikasi.
CPU, RAM, dan disk NVMe khusus untuk Anda di atas virtualisasi KVM.
Tambah RAM, CPU, dan disk saat beban bertambah, tanpa pindah server.
Tim teknis siap membantu lewat live chat, WhatsApp, dan tiket.
Ollama / LLM Lokal paling cocok di Cloud VPS.
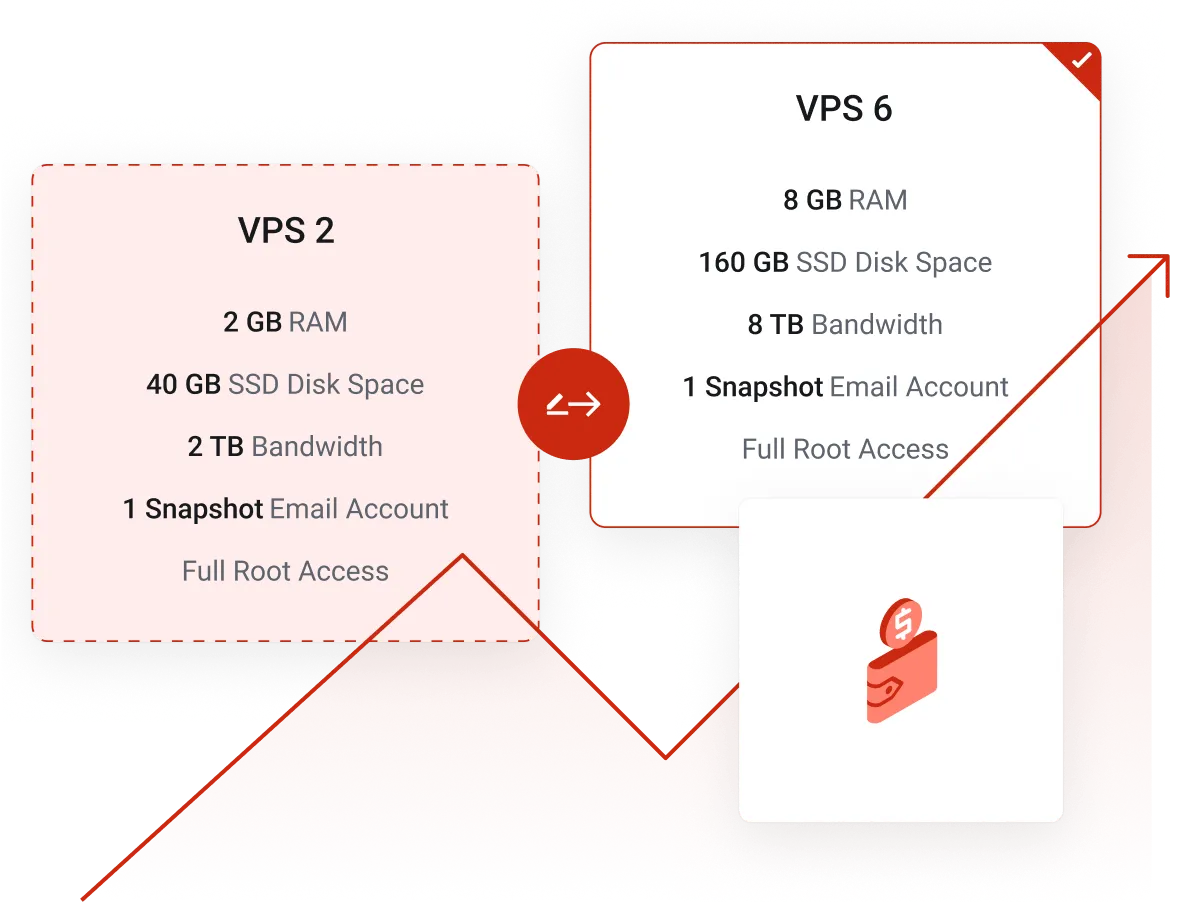
Mulai 8 GB RAM untuk model 7–8B. Server berbasis CPU, cocok untuk tugas batch dan chatbot internal.
Bayar Rp 6.599.988 per tahun, hemat Rp 1.320.000.
Pesan SekarangAktif otomatis setelah pembayaran terkonfirmasi.
Mulai dari RAM 8 GB untuk Ollama; upgrade kapan saja saat beban bertambah.
Pilih Ubuntu atau Debian, lalu pasang Ollama, atau minta tim kami memasangkannya.
Ollama aktif terus di server Anda dengan akses root penuh.
Belum menemukan jawaban? Tim kami siap membantu.
Kunjungi Pusat BantuanTidak. Cloud VPS kami berbasis CPU. Model kecil hingga menengah tetap bisa berjalan, dengan kecepatan yang cocok untuk tugas batch, otomasi, dan chatbot internal.
Dengan 8 GB RAM, model 7–8B terkuantisasi (misalnya Llama 3.1 8B atau Qwen 7B) dapat berjalan. Untuk model lebih besar, pilih 16 GB atau 32 GB RAM.
Bisa. Ollama menyediakan API lokal yang dapat dipanggil n8n, Flowise, OpenClaw, atau aplikasi Anda sendiri.
Data tidak keluar dari server Anda dan tidak ada biaya per token. Untuk kualitas atau kecepatan tertinggi, API model komersial masih bisa dipakai berdampingan.